1. Introducción
La deserción estudiantil en la educación superior constituye un problema multidimensional con graves implicaciones éticas, sociales y económicas. En los programas de ingeniería de Colombia, las estadísticas oficiales señalan que más del 40% de los estudiantes que ingresan a primer semestre abandonan las aulas antes de culminar el ciclo de fundamentación científica.
En el litoral Pacífico, factores estructurales como la brecha en formación matemática previa, las dificultades de acceso a conectividad domiciliaria y la precariedad económica agravan los índices de abandono. Detectar tempranamente a los estudiantes en condición de vulnerabilidad resulta indispensable para que las áreas de Bienestar Universitario y las coordinaciones académicas implementen tutorías y auxilios a tiempo.
El propósito de este artículo es formular, entrenar y validar un pipeline computacional de aprendizaje supervisado que identifique con alta precisión los factores determinantes del abandono y emita alertas tempranas automáticas previas a la semana 8 del semestre lectivo.
2. Metodología y Procesamiento de Datos
Se estructuró un conjunto de datos anonimizado que recopiló registros históricos de 1,280 estudiantes matriculados en programas de ingeniería de la Universidad del Pacífico entre 2021 y 2025. La base de datos incluyó 28 atributos, clasificados en cuatro dimensiones: académica (puntaje Saber 11, promedio de primer corte), socioeconómica (estrato, ingresos familiares, condición de desplazamiento o víctima), demográfica (municipio de procedencia, régimen de traslado) y tecnológica (disponibilidad de computador propio y tipo de conexión a internet).
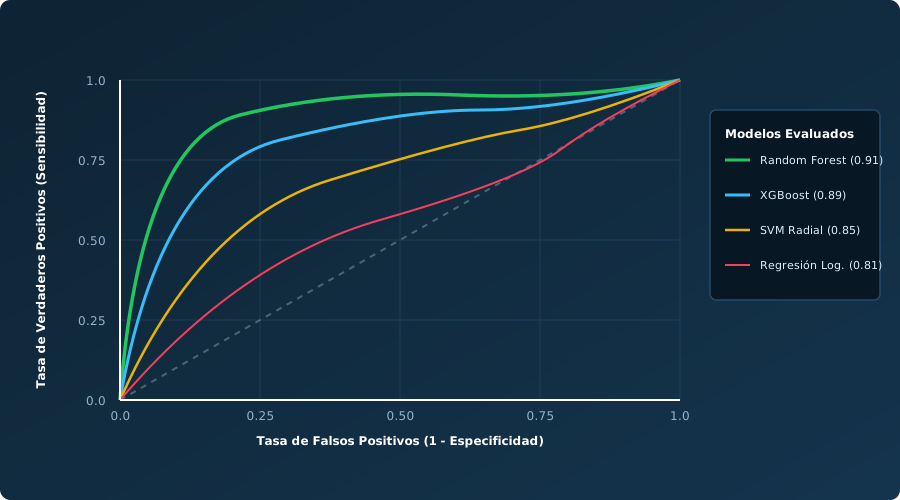
Para mitigar el desbalance de clases inherente al fenómeno de deserción (ratio aproximado 70/30), se empleó la técnica de sobremuestreo sintético SMOTE (Synthetic Minority Over-sampling Technique). Se entrenaron y validaron cuatro algoritmos de clasificación mediante validación cruzada estratificada de 10 particiones (k-fold): Regresión Logística regularizada (L2), Máquinas de Vectores de Soporte (SVM), Gradient Boosting (XGBoost) y Bosques Aleatorios (Random Forest).
3. Resultados y Discusión
La evaluación comparativa arrojó que el modelo basado en Random Forest obtuvo el mejor rendimiento global, alcanzando una precisión (precision) del 89.1%, una exhaustividad (recall) del 87.8%, un F1-score de 0.884 y un área bajo la curva ROC (AUC-ROC) de 0.912, superando significativamente a la Regresión Logística (AUC-ROC de 0.814).
El análisis de importancia de características mediante valores SHAP (SHapley Additive exPlanations) reveló que las variables con mayor peso explicativo sobre el riesgo de deserción fueron: (1) el rendimiento en el primer examen parcial de matemáticas operativas; (2) la condición de residencia rural o desplazamiento fluvial; y (3) la ausencia de computador propio en el hogar para prácticas de programación.
Estos hallazgos permitieron diseñar un tablero de analítica predictiva accesible por la coordinación del programa, el cual clasifica a la cohorte en tres niveles de riesgo (bajo, medio, alto) y facilita intervenciones pedagógicas preventivas focalizadas.
4. Conclusiones
Los algoritmos de aprendizaje automático demuestran ser herramientas eficaces y objetivas para anticipar el fenómeno del abandono universitario en contextos de alta vulnerabilidad social y geográfica.
La integración de técnicas de explicabilidad (SHAP) resultó fundamental para garantizar que las predicciones no operen como cajas negras, permitiendo a los directores de programa comprender las causas específicas que afectan a cada estudiante y diseñar planes de tutoría personalizados.
El modelo desarrollado sienta las bases para un sistema institucional continuo de retención estudiantil, con capacidad de retroalimentarse semestralmente con nuevos datos académicos y socioeconómicos.